Google публикува изследване за система за откриване на спам, наречена SAFE, която имитира начина, по който човек би извършил ръчна проверка. Системата може да открива съдържание, което нарушава не само конкретни правила, но и техния „дух“, както и по-общите насоки на платформата.
SAFE е съкращение от Scaled Abuse Forensics Examiner и е разработена специално за идентифициране на злоупотреби със съдържание, генерирано чрез изкуствен интелект.
Google насочва вниманието си към AI slop
Това е втората система на Google, идентифицирана през 2026 г., която е създадена за откриване на спам, генериран с AI.
По-рано беше описана системата Scalable Cluster Termination System, или S-CTS. Фактът, че Google отделя ресурси за разпознаване и ограничаване на т.нар. AI slop, показва нарастващото внимание на компанията към масово генерираното синтетично съдържание.
В SEO общността се обсъжда и възможността подобни системи да имат отношение към септемврийската актуализация срещу спама на Google. Към момента обаче това остава предположение, а не потвърдена връзка.
Генеративният AI позволява на мрежи за злоупотреби да произвеждат огромни количества синтетично съдържание, като същевременно систематично го променят, за да избягват традиционните механизми за откриване.
Хората могат да разпознават координирани спам мрежи чрез анализ на връзките между отделните участници, поведението им, съдържанието и дори инфраструктурата зад тях. Проблемът е, че ръчните проверки не могат да бъдат мащабирани достатъчно бързо, за да се справят с количеството AI съдържание.
Новата система е предназначена именно да намали тази разлика.
Изследването е озаглавено „The Synthetic Gap: Automating Forensic Investigation of ‘AI Slop’ with the Scaled Abuse Forensics Examiner (SAFE)“.
Авторите обясняват:
„Традиционните процеси за форензичен анализ, които разчитат в голяма степен на ръчно разпознаване на модели и анализ на метаданни, не са достатъчно добре подготвени да се справят с този обем. „Синтетичната пропаст“, времето между появата на нов генеративен вектор за атака и внедряването на противодействие, остава критична уязвимост.“
SAFE открива нарушения на „духа“ на правилата
Според изследването SAFE може да идентифицира нарушения на „духа на правилата“ основно чрез голям езиков модел, обучен с few-shot подход.
Целта е системата да открива съдържание, което може да не съответства точно на вече дефинирано нарушение или на познат модел за злоупотреба, но въпреки това нарушава основния замисъл на правилата или насоките на платформата.
Именно такова съдържание може да остане незабелязано от традиционните класификатори и специално обучените модели за откриване на нарушения.
SAFE не разчита единствено на анализ на отделни визуални или текстови елементи. Системата използва и семантичен анализ, за да открива по-фини модели и нововъзникващи форми на злоупотреба.
Системата SAFE вече е внедрена
Изследването е необичайно кратко и обхваща само три страници. В него се споменава оценяване на системата, но не са публикувани конкретни количествени резултати от тестовете.
Въпреки това авторите посочват, че SAFE вече е внедрена.
В документа се казва:
„Първоначалните резултати от внедряването показват, че SAFE значително ускорява идентифицирането на нови синтетични заплахи, като намалява времето за форензично разследване в сравнение с работните процеси с човешко участие.“
Публикацията посочва и показателите, по които системата ще бъде оценявана. Сред тях са точността спрямо решенията на човешки анализатори, способността да открива тенденции при злоупотреби, пропускани от съществуващите ML класификатори, както и намаляването на времето, необходимо за разследване.
Google Research действително описва SAFE като автоматизирана многоагентна архитектура, а публикацията потвърждава наличието на ранни резултати от внедряването.
Трите технически основи на SAFE
Разделът за технологичната основа на SAFE описва три ключови направления, които системата комбинира за мащабно откриване на злоупотреби със синтетично съдържание.
1. Откриване на неорганично поведение
SAFE търси координирано поведение, което се различава от нормалната човешка активност.
Системата анализира модели като времето на публикуване, внезапни серии от активност, използвана инфраструктура, поведение при публикуване и други общи сигнали между множество профили или канали.
В изследването се посочва:
„Разпространението на бот мрежи и координирани злонамерени кампании налага използването на надеждни методи за идентифициране на модели на ангажираност, които не произхождат от хора.“
Сред примерите, описани в документа, са синхронизирано качване на съдържание, burst публикуване, общи характеристики на устройствата и инфраструктурни сигнали.
2. Автоматизирана форензика чрез многоагентни системи
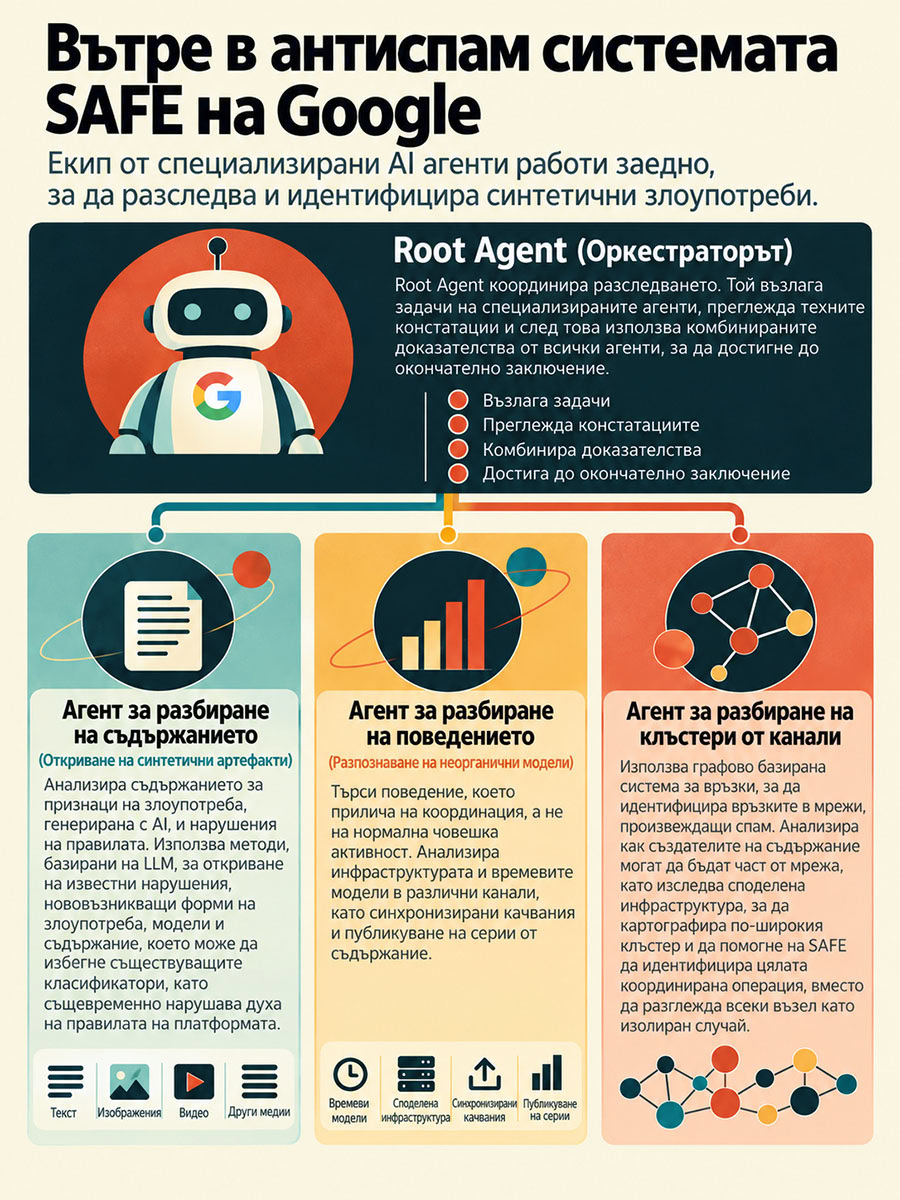
SAFE използва специализирани AI агенти, които разделят форензичното разследване на отделни задачи.
Над тях работи централен агент, наречен Root Agent, който управлява останалите агенти, анализира резултатите им и стига до окончателно заключение.
Този подход позволява различните части на разследването да бъдат автоматизирани и извършвани паралелно, вместо всички сигнали да бъдат обработвани от един модел.
3. Transformer модели за разбиране на съдържание и прилагане на правилата
SAFE използва transformer базирани модели за анализ на значението и контекста на съдържанието.
Системата включва и мултимодален анализ, който позволява едновременно да бъдат разглеждани различни типове сигнали.
Това дава възможност да се откриват не само предварително известни нарушения, но и съдържание, което заобикаля традиционните филтри, въпреки че нарушава основния замисъл на правилата.
SAFE използва четири специализирани AI агента
Изследването описва четири основни компонента:
- Root Agent, централен оркестратор
- Content Understanding Agent, анализ на съдържанието и синтетичните артефакти
- Behavior Understanding Agent, откриване на неорганични модели
- Channel Cluster Understanding Agent, анализ на връзките между каналите
Root Agent управлява цялото разследване
Root Agent е централният механизъм за вземане на решения.
Той получава за анализ предполагаем клъстер от канали и динамично разпределя задачите между останалите специализирани агенти.
След това оценява техните заключения и обединява структурираното доказателство от анализа на съдържанието, поведението и взаимоотношенията между каналите.
На тази база Root Agent определя дали наблюдаваният клъстер представлява координирана атака със синтетично съдържание или органична активност.
Content Understanding Agent търси AI злоупотреби
Content Understanding Agent анализира съдържанието за признаци на генериране чрез AI и за нарушения на правилата.
Той използва LLM методи както за откриване на известни нарушения, така и за идентифициране на нововъзникващи форми на злоупотреба.
Системата използва LoRA адаптиран голям езиков модел за специализирано откриване на нарушения.
При т.нар. нарушения на „духа на правилата“ се прилага few-shot обучен LLM, който трябва да разпознава по-фини случаи, способни да избегнат традиционните класификатори и специално обучените модели.
Агентът анализира и мултимодални семантични представяния, за да идентифицира общи следи от синтетично производство между различни канали.
Сред сигналите са повтарящи се сценарии и структурни визуални несъответствия, характерни за автоматизирано генериране.
Behavior Understanding Agent анализира координираното поведение
Behavior Understanding Agent търси активност, която изглежда като резултат от координация, а не от нормално човешко поведение.
Той анализира инфраструктурни и времеви модели между различни канали.
Сред наблюдаваните сигнали са синхронизирани качвания, публикуване на голям брой материали в кратък период, ASN информация и отпечатъци на устройствата.
Целта е да бъдат открити скрити признаци, че различни на пръв поглед канали всъщност са част от една и съща координирана операция.
Channel Cluster Understanding Agent картографира мрежите
Channel Cluster Understanding Agent използва графова система за анализ на взаимоотношенията между участниците в предполагаемата спам мрежа.
Той проверява връзките между отделните акаунти и каналите и използва споделени инфраструктурни сигнали, за да картографира по-големия клъстер.
Това позволява на SAFE да анализира цялата координирана операция, вместо всеки отделен канал да бъде разглеждан като изолиран случай.
Агентът използва графово базирана Relationship Signal услуга, която открива установени връзки между каналите в предполагаемия клъстер. След това се извършва допълнителен анализ на необработените сигнали за взаимоотношения, за да бъдат открити по-слабо очевидни признаци на координация.
Какво показва SAFE за подхода на Google към AI спама
Част от SEO общността смята, че Google използва системи за разпознаване на AI съдържание при борбата със спама.
Новото изследване показва, че разработваните от компанията технологии могат да отиват значително по-далеч от обикновеното определяне дали дадено съдържание е генерирано от AI.
SAFE е проектирана да работи по начин, който наподобява екип от човешки форензични анализатори. Вместо да разглежда единствено конкретен материал, системата комбинира информация за съдържанието, поведението, инфраструктурата и взаимоотношенията между създателите на съдържание.
По този начин целта е да бъдат идентифицирани цели мрежи за синтетични злоупотреби, включително случаи, които не попадат точно в предварително дефиниран модел за нарушение.
Самото изследване потвърждава архитектурата и ранното внедряване на SAFE. То обаче не установява връзка между системата и септемврийската актуализация срещу спама в Google Search. Актуализацията започна на 24 септември 2026 г., обхваща всички езици и според Google може да се внедрява до две седмици.